Алгоритмы · лекция 1 · 03.10.2026
Основные понятия алгоритмов, данных и структур хранения
1 Алгоритм как процедура преобразования данных
Алгоритм — трактуемая процедура, осуществляемая «черным ящиком» для получения выхода из входа. Черным ящиком может быть человек или любое устройство. В общем виде это можно записать как
алгоритм: входные данные → выходные данные.
Актуальная справочная формулировка NIST DADS близка по смыслу: алгоритм — вычислимый набор шагов для достижения требуемого результата. (xlinux.nist.gov)
алгоритм: входные данные → выходные данные.
Актуальная справочная формулировка NIST DADS близка по смыслу: алгоритм — вычислимый набор шагов для достижения требуемого результата. (xlinux.nist.gov)
Процедура — конечная последовательность точно определенных шагов или операций, для выполнения каждой из которых требуется конечный объем оперативной памяти и конечное время. Чтобы создать алгоритм, необходимо знать: входные данные, выходные данные и работу, которую алгоритм должен выполнять.
2 Принципы построения алгоритма
Любой алгоритм применяется к исходным данным и дает результат. В ходе работы алгоритма появляются промежуточные результаты; каждый алгоритм имеет дело с данными.
Данные представляют собой абсолютно любую информацию. Для размещения данных требуется память. В модели лекции память считается однородной и дискретной: она состоит из одинаковых ячеек, причем каждая ячейка может содержать один символ алфавита данных. Поэтому единицы измерения данных и памяти согласованы. В теоретическом рассмотрении память может считаться бесконечной.
Алгоритм состоит из отдельных элементов-шагов; множество различных шагов, из которых состоит алгоритм, конечно. Последовательность шагов детерминирована: после каждого шага указано, какой шаг выполнять дальше, либо дана команда остановки, после чего работа алгоритма заканчивается. Для детерминированного алгоритма поведение полностью определяется входом. (xlinux.nist.gov)
Результативность алгоритма — требование, которое проверить гораздо труднее, чем предыдущие. Описание алгоритмов включает механизм организации: средство поиска остановки, реализацию элементов-шагов, выдачу результатов и управление ходом вычисления.
Процесс реализации — определенная последовательность шагов, которая приводит к результату.
3 Представление информации и типы данных
При разработке программы возникает задача представления, моделирования и использования разных видов информации. Информация — абстрактное содержание какого-либо описания, указания или сообщения. Внешнюю форму информации называют представлением. Информация в абстрактном виде не может быть записана напрямую, а должна быть представлена.
При разработке программы используется тип данных. Данные делятся на простые и структурные. К простым данным относят целые и вещественные числа, литералы, логические значения: ложь или истина. К структурным данным относят массивы, записи, файлы и т. п.
Типы данных в описании задачи программирования можно поделить на стандартные и произвольные. Стандартные типы характеризуют язык программирования; их спецификацию осуществляют разработчики языка. Произвольные типы характеризуют конкретные программы; их спецификацию и реализацию осуществляют пользователи.
Стандартные и произвольные типы можно поделить на конкретные и родовые. Конкретный тип характеризует определенное множество значений, не требует дальнейшей конкретизации и готов к непосредственному употреблению. Родовой тип характеризует множество множеств значений и требует конкретизации; переменная такого типа не может быть полностью обработана до завершения конкретизации.
4 Структуры данных и выбор формы хранения
Структура данных — организация информации, обычно в памяти, для повышения эффективности алгоритма; к таким структурам относятся очередь, стек, связанный список, дерево и другие. Выбор структуры данных может существенно повлиять на скорость и эффективность реализации алгоритма. (xlinux.nist.gov)
Массив помогает объединять множество данных в осмысленные группы. Имена массивов с индексами уменьшают потребность заводить множество отдельных имен для элементов. Использование индексов обеспечивает непосредственный доступ к любому элементу массива; индексация позволяет с помощью циклов автоматически выполнять обработку данных: инициализацию, поиск, хранение, модификацию.
Комментарий от ИИ: в материале указано «Массив: недостатков нет»; сейчас по актуальным справочным источникам это слишком сильная формулировка: NIST DADS указывает, что вставка в массив требует $O(n)$ времени, а неупорядоченный массив ищется линейным поиском. (xlinux.nist.gov)
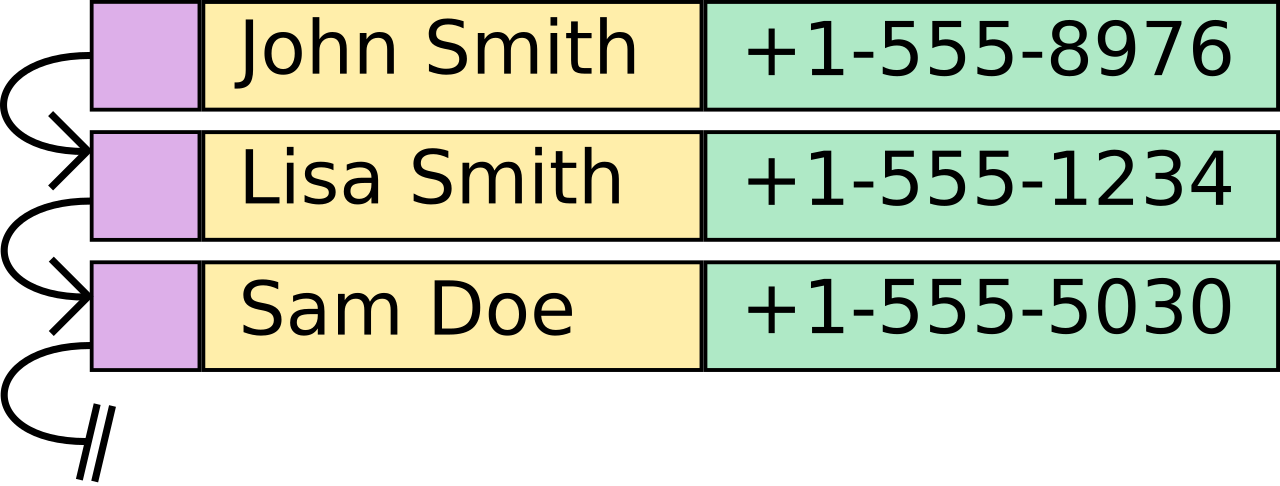
Связанный список — структура данных, которая требует дополнительной памяти, но позволяет легко вносить изменения. Линейно-связанный список — конечный набор пар; каждая пара состоит из информационной и указывающей части. Каждая такая пара называется ячейкой.
Линейно-связанные списки эффективны для моделирования ситуаций, где упорядоченные массивы элементов данных часто изменяются. Особенно это относится к случаям, когда модификация — это внесение элементов в середину массива или удаление элементов из середины. Справочная статья NIST также отмечает, что связанный список может использоваться для реализации очереди, стека или разреженной матрицы. (xlinux.nist.gov)
5 Стек, очередь и деревья
Стек в конспекте описан как бесконечная в одну сторону последовательность слов в памяти: для запоминания элемента он записывается в верхнее слово, а другие слова стека сдвигаются вниз; выбор элемента возможен только считыванием по одному из вершины.
Комментарий от ИИ: в материале стек описан через «бесконечную последовательность» и сдвиг всех слов вниз; сейчас в справочном определении NIST стек — это коллекция, где удалить можно только последний добавленный элемент, верхний элемент находится сверху, основные операции — push и pop, принцип — LIFO. (xlinux.nist.gov)
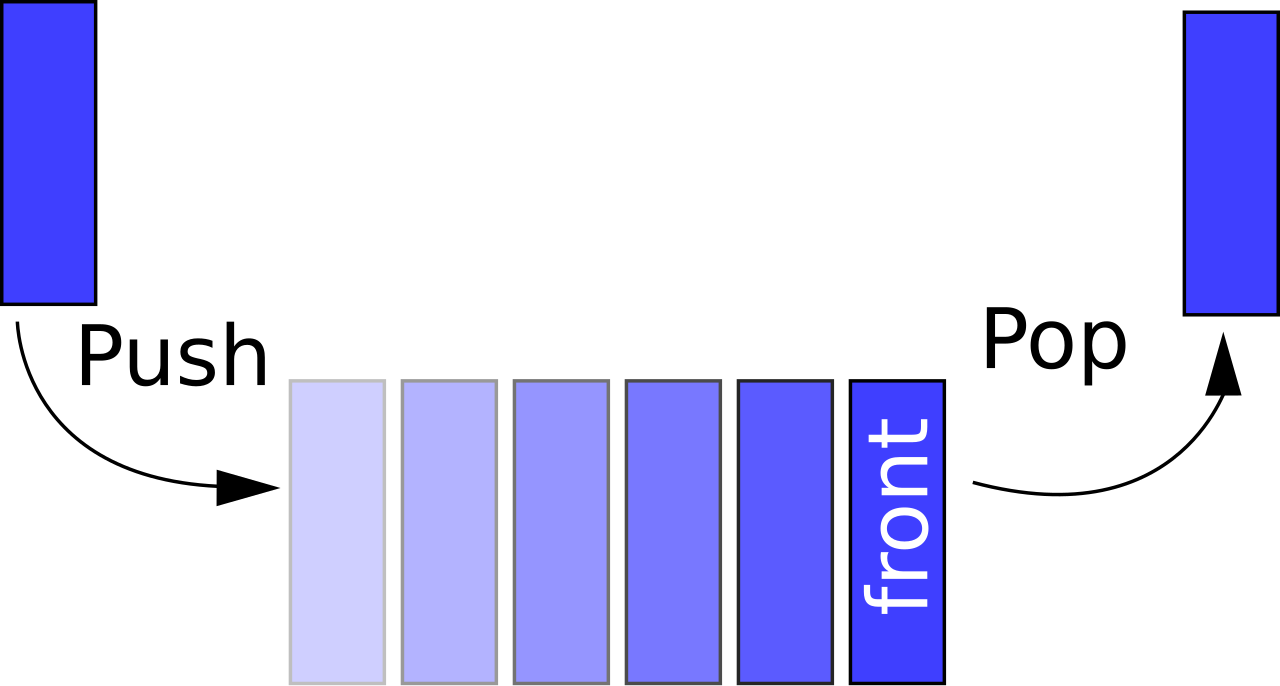
Очередь — структура, в которой элементы добавляются с одного конца, а выбираются с другого. Для моделирования очереди используется линейный массив и две переменные, указывающие на первый и последний элемент в очереди. В актуальной терминологии очередь реализует принцип FIFO: первым обрабатывается элемент, который поступил раньше. (xlinux.nist.gov)
Комментарий от ИИ: в материале сказано, что если изменения касаются начала и конца, связанный список не нужен и используют стек; сейчас по актуальным определениям это верно только для доступа к одному концу по принципу LIFO. Для добавления с одного конца и выбора с другого используется очередь. (xlinux.nist.gov)
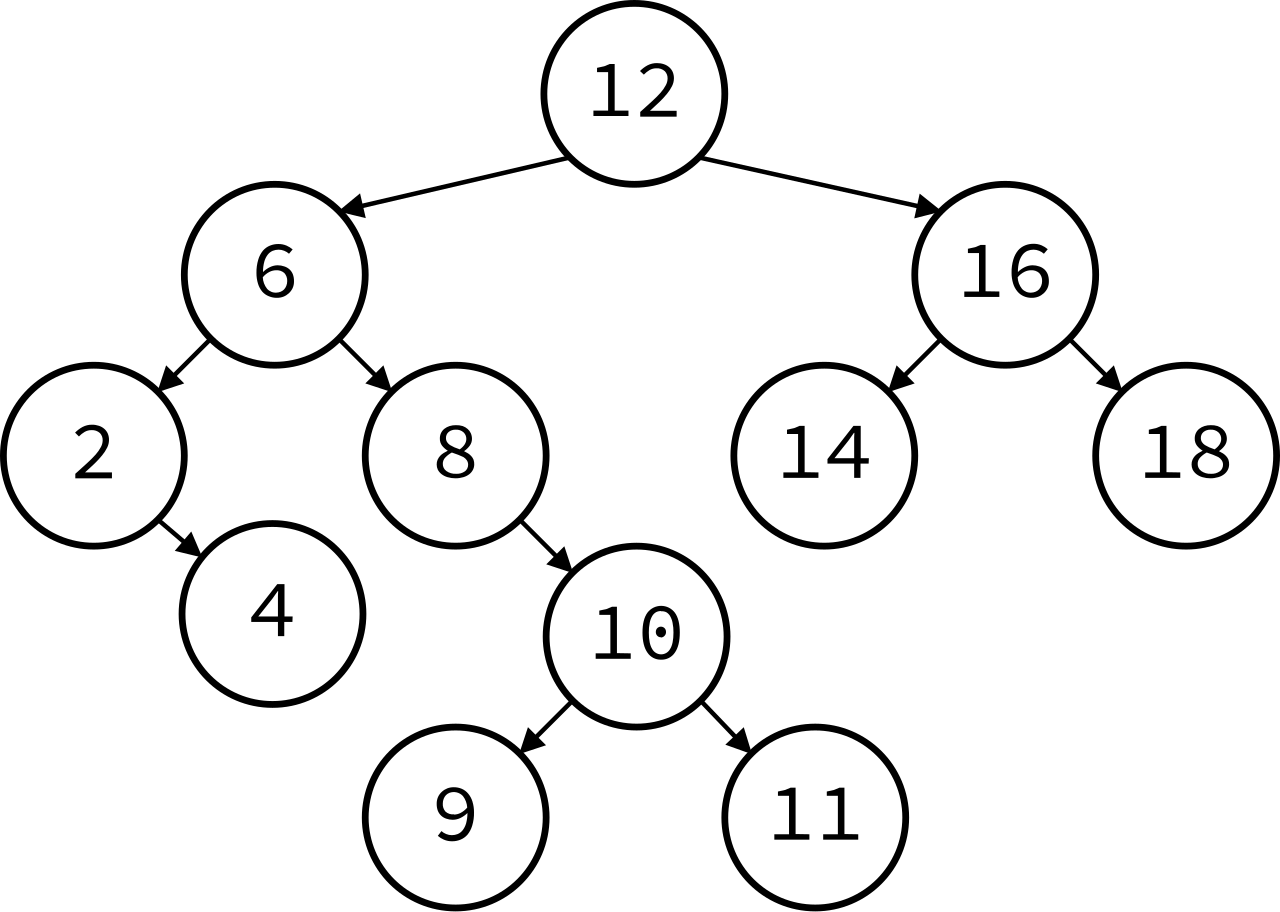
Деревья — важные нелинейные структуры, встречающиеся в вычислительных алгоритмах. Всякая иерархическая классификационная схема в конечном виде может быть представлена деревом. Наиболее важный вид — бинарное, или двоичное, дерево.
Двоичное дерево определяется конечным множеством узлов: оно либо пусто, либо состоит из корня и двух двоичных поддеревьев. Обход дерева — методическое исследование узлов дерева, при котором каждый узел проходится один раз; например, при симметричном обходе сначала обрабатывается левое поддерево, затем корень, затем правое поддерево. (xlinux.nist.gov)
6 Практическая работа по сортировкам
В практической части требуется произвести подсчет числа сравнений и количества пересылок, полученных при сортировке заданного варианта массива методом вставки. Затем нужно сравнить полученные данные с сортировкой методом пузырька по эффективности.
Метод простых вставок сортирует данные, многократно беря следующий элемент и вставляя его в правильное место относительно уже вставленных элементов. Для этого метода характерно время работы O(n^2) из-за перемещений элементов. (xlinux.nist.gov)
Для сортировки пузырьком элементы сравниваются попарно с соседними элементами, при необходимости меняются местами, и проходы повторяются, пока обменов больше нет. Для произвольных данных сложность пузырьковой сортировки — O(n^2), но для почти упорядоченного списка она приближается к \Theta(n). (xlinux.nist.gov)
В отчете по работе должны быть: краткое изложение рассматриваемого метода сортировки; блок-схема алгоритма; таблица последовательности сортировки вручную заданного массива чисел; анализ эффективности метода вставок с подсчетом числа сравнений и пересылок; сравнительный анализ с теоретическими данными и с методами пузырька и выбора; результаты сортировки на ЭВМ с распечаткой и комментариями.
Контрольные вопросы: является ли метод простых вставок устойчивым; как сравнить сложность программ для методов пузырька и вставок; нужен ли при использовании метода вставок резерв памяти; что такое число инверсий; зависит ли число сравнений и пересылок от исходного массива чисел; для чего необходима сортировка; что такое бинарные вставки и двухпутевые вставки.
Сортировка Шелла рассматривается как способ ускорить простые вставки: если алгоритм каждый раз перемещает запись только на одну позицию, как в простых вставках, среднее время работы в лучшем случае пропорционально N^2. Метод Шелла использует механизм больших «скачков»: это первая сортировка с уменьшающимся шагом, где на проходах сортируются группы элементов, обычно вставками, а шаг уменьшается до 1. (xlinux.nist.gov)
Комментарий от ИИ: в материале указано «метод впервые был предложен Л. Шеллом»; сейчас по актуальным источникам NIST метод связывается с Donald Lewis Shell и публикацией “A High-Speed Sorting Procedure” 1959 года. (xlinux.nist.gov)